میز کار یک ویراستار باسابقه همیشه تصویر مشخصی در ذهنها میسازد: انبوهی از برگههای پرینتشده، چند جلد فرهنگ لغت سنگین مثل دهخدا و سخن، کتاب غلطنگوییم ابوالحسن نجفی که از فرط ورقخوردن شیرازهاش شل شده، و البته یک خودکار قرمز که بیرحمانه روی کلمات خط میکشد. ده سال پیش، اگر کسی به یک متخصص ادبیات فارسی میگفت که روزی یک ربات نرمافزاری قرار است در کمتر از سه ثانیه، متنهای پنجاهصفحهای را از نظر نگارشی و دستوری شخم بزند، احتمالاً فقط یک لبخند تمسخرآمیز تحویل میگرفت. اما امروز ورق برگشته است. پدیدهای به نام ویراستاری با هوش مصنوعی دیگر یک شوخی علمیتخیلی نیست؛ واقعیتی است که درست وسط میز تحریر نویسندگان، مترجمان و ناشران نشسته است.
ویراستاری رایگان با هوش مصنوعی بله
بسیاری از اهالی قلم هنوز هم وقتی نام هوش مصنوعی ویراستاری به میان میآید، گارد میگیرند. حق هم دارند. زبان فارسی با آن همه ظرافت، استعاره، کنایه و پیچوخمهای نحوی، چیزی نیست که به این راحتیها در قالب صفر و یک بگنجد. ماشین از کجا میفهمد که فرق «شیر» در جملهی «شیر درنده» با «شیر سماور» چیست؟ یا چطور میتواند تشخیص دهد که یک نویسندۀ معاصر، به عمد ساختار جمله را شکسته تا حس دلهره و شتاب را به خواننده منتقل کند؟
با این حال، بررسی دقیقتر ماجرا نشان میدهد که این ابزارهای نوظهور، اگر درست شناخته شوند و در جای درست به کار گرفته شوند، نه تنها دشمن ادبیات و نگارش نیستند، بلکه میتوانند مثل یک دستیار خستگیناپذیر، بارِ سنگین و طاقتفرسای کارهای تکراری را از دوش انسان بردارند. در این نوشتار، بدون استفاده از عبارتهای کلیشهای و تعریفهای خشک کامپیوتری، قرار است زیر و بم ویراستاری متن با هوش مصنوعی از دیدگاه علمی و تجربی کالبدشکافی شود تا مشخص گردد کجای کار را باید به ماشین سپرد و کجا هنوز قلم انسان حرف اول و آخر را میزند.
از غلطگیرهای ساده تا مدلهای زبانی پیچیده؛ چه اتفاقی افتاد؟
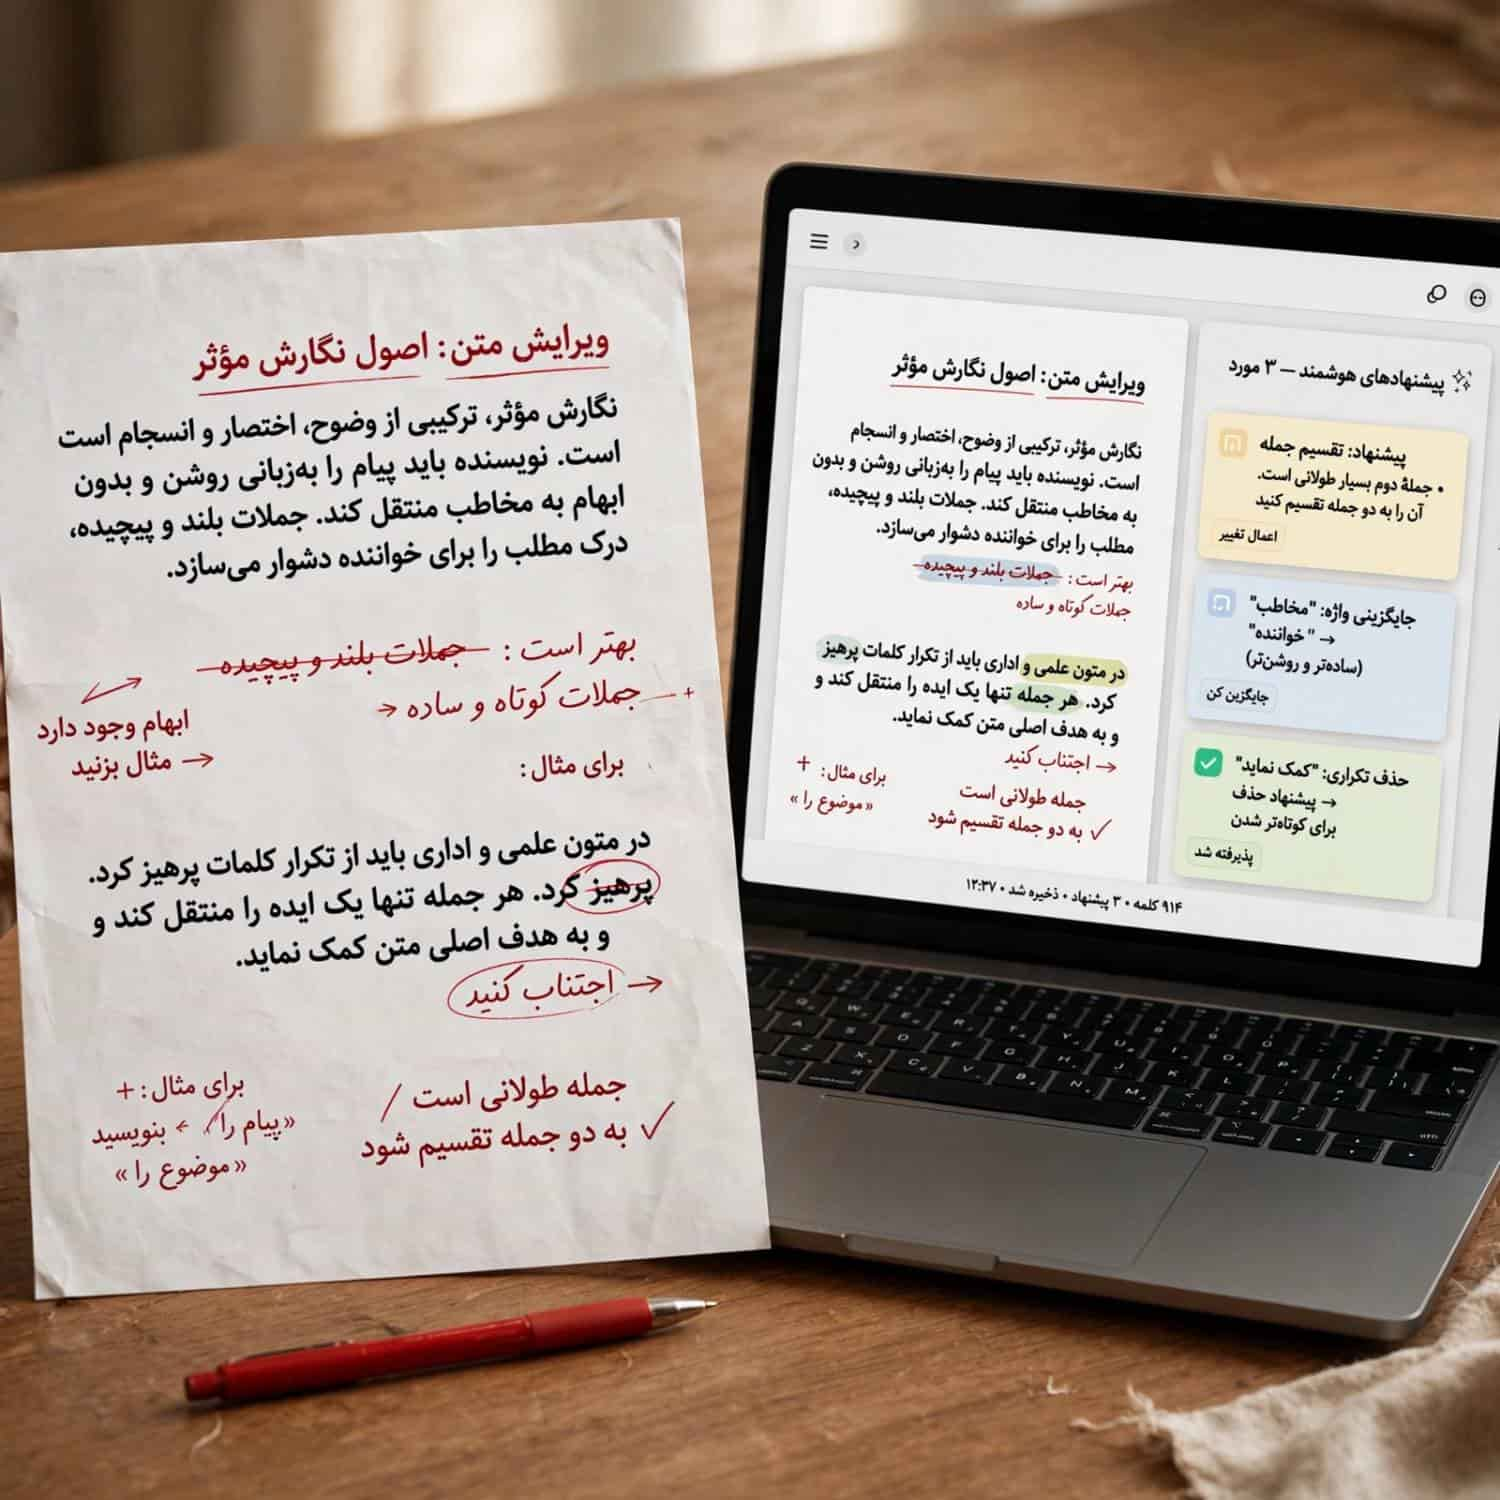
تا همین چند سال پیش، نهایت کاری که کامپیوتر برای متن فارسی انجام میداد، همان خطوط زیگزاگ قرمزرنگی بود که نرمافزار ورد (Word) زیر کلمات میکشید. آن سیستمهای قدیمی بر پایۀ یک بانک اطلاعاتی ساده کار میکردند؛ یعنی کلمه را با فهرست خودشان تطبیق میدادند و اگر در لیست نبود، خطا میگرفتند. برای همین، اگر کسی مینوشت «من به خار و بار فروشی رفتم»، سیستم هیچ خطایی نمیگرفت، چون هم «خار» و هم «بار» در لغتنامه وجود داشتند، در حالی که املای درست در این بافت، «خواروبار» است.
اما نسل جدید ابزارها که بر پایۀ مدلهای زبانی بزرگ (LLM) و پردازش زبان طبیعی (NLP) کار میکنند، دیگر کلمه را تنها نمیبینند. آنها بافتار یا همان «کانتکست» (Context) را میخوانند. وقتی صحبت از ویرایش متن با هوش مصنوعی در سالهای اخیر میشود، منظور سیستمی است که میلیاردها جمله و متن را خوانده، الگوی قرار گرفتن کلمات کنار هم را یاد گرفته و حالا میتواند حدس بزند که در جملهی بالا، منظور نویسنده گیاه بیابانی نبوده، بلکه مواد غذایی مد نظر بوده است.
در واقع، این ابزارها سه سطح از ویرایش را به شکل همزمان شبیهسازی میکنند:
اول، ویرایش صوری و نگارشی است؛ یعنی همان تنظیم نیمفاصلهها، نقطهگذاریها، تبدیل «ی» و «ک» عربی به «ی» و «ک» فارسی، و حذف فاصلههای اضافه.
دوم، ویرایش زبانی و ساختاری است که به تطابق نهاد و گزاره، حذف حشوها، اصلاح جملات مجهول و برطرف کردن گرتهبرداریهای ترجمهای مربوط میشود.
سوم، تلاش برای ورود به حوزۀ بازنویسی و تغییر لحن است؛ جایی که ماشین سعی میکند یک متن عامیانه را به رسمی تبدیل کند یا برعکس.
کالبدشکافی عملی: ماشین چطور متن فارسی را جراحی میکند؟
برای اینکه بحث از حالت تئوری خارج شود، هیچچیز بهتر از بررسی نمونههای واقعی نیست. فرض کنید متنی خام و پر از ایرادهای رایج، تحویل یک سیستم هوش مصنوعی برای ویراستاری داده میشود. بیایید ببینیم در برخورد با لایههای مختلف خطاهای زبانی، عملکرد این دستیار دیجیتالی چگونه است.
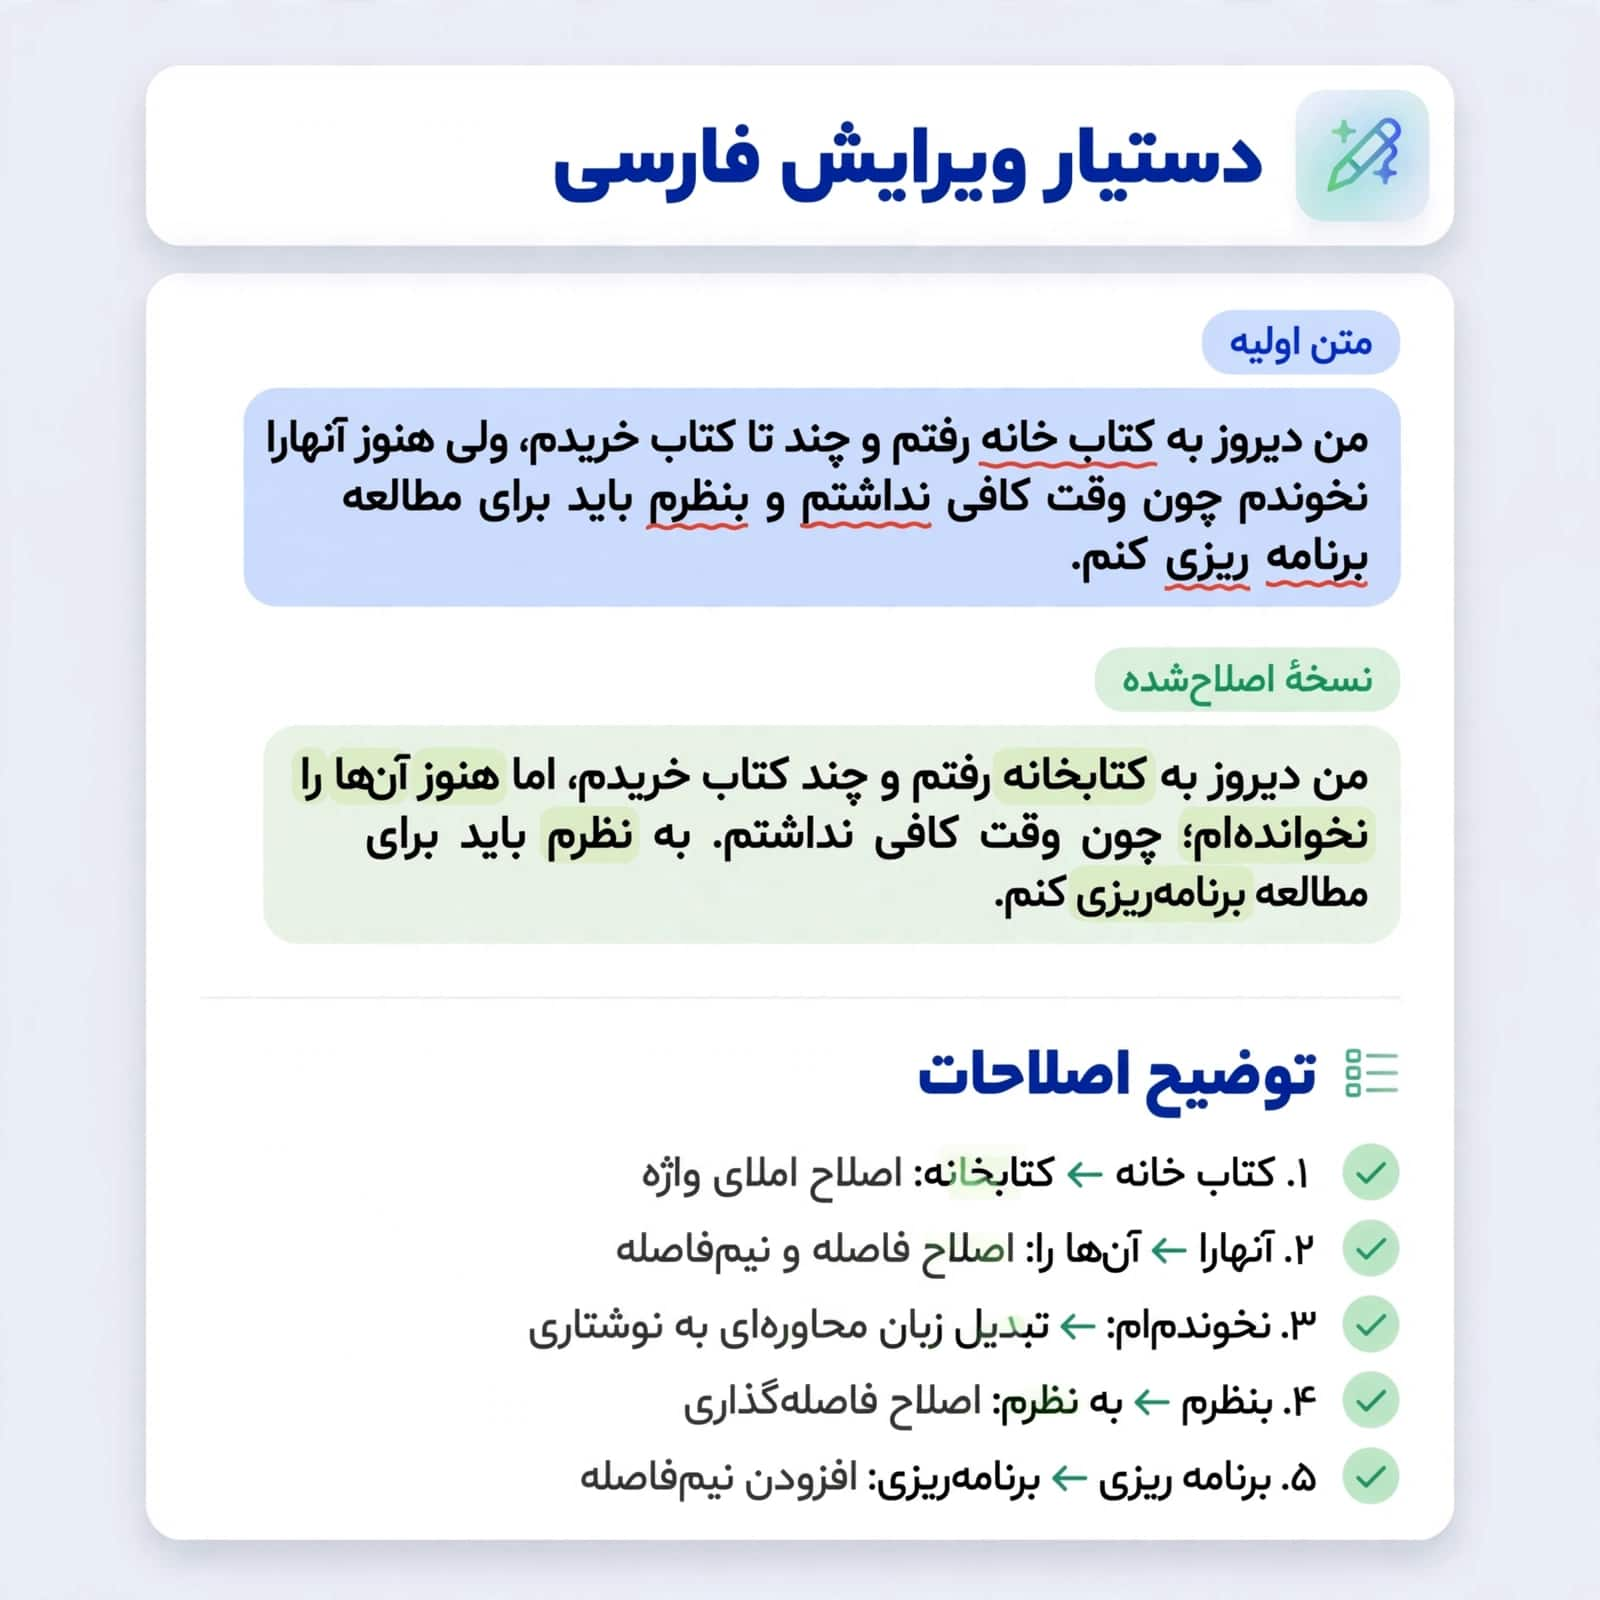
مثال اول: معضل همیشگی نیمفاصله و سجاوندی (ویرایش صوری)
متن خام نویسنده: «کتابهایی که در باره ی تاریخ معاصر نوشته شده اند ، اغلب به جزییات نمیپردازند .»
خروجی ماشین: «کتابهایی که دربارۀ تاریخ معاصر نوشته شدهاند، اغلب به جزئیات نمیپردازند.»
در این سطح، نرم افزار ویراستاری هوش مصنوعی بیرقیب است. چشم انسان، حتی چشم یک ویراستار باتجربه که ده سال است متن میخواند، در صفحۀ صد و پنجاهم یک کتاب ممکن است خسته شود و یک فاصلۀ اضافه قبل از ویرگول را نبیند. اما ماشین خسته نمیشود. در کسری از ثانیه تمام «ها»ی جمع، پیشوندهای «می» و «نمی»، و فاصلهگذاریهای علائم نگارشی را طبق دستور خط فرهنگستان زبان و ادب فارسی یکدست میکند. برای همین است که در پروژههای ویراستاری کتاب با هوش مصنوعی، فاز اول کار یعنی پاکنویس کردن و استانداردسازی ظاهری متن، با سرعتی باورنکردنی پیش میرود.
مثال دوم: دستوپنجه نرم کردن با جملات ترجمهزده (ویرایش زبانی)
یکی از بزرگترین دردسرهای ویراستاران در ایران، متونی است که بوی ترجمه میدهند؛ حتی اگر نویسندهشان ایرانی باشد! نفوذ ساختار زبان انگلیسی در فارسی امروز بیداد میکند.
متن خام: «این تصمیم توسط مدیرعامل گرفته شد و او در حال داشتن یک روز سخت بود.»
این جمله برای هر کسی که کمی ذوق ادبی داشته باشد، مثل کشیدن ناخن روی تخته سیاه است!
وقتی از یک مدل پیشرفتهی هوش مصنوعی خواسته میشود که این جمله را بر اساس نثر معیار و طبیعی فارسی ویرایش کند، چنین پیشنهادی میدهد:
خروجی ماشین: «مدیرعامل این تصمیم را گرفت؛ او روز سختی را میگذراند.»
اینجا دقیقاً همان نقطهای است که هوش مصنوعی قدرت واقعیاش را نشان میدهد. سیستم متوجه شده که عبارت «توسطِ… گرفته شد» یک ساختار مجهولِ تحمیلی است و آن را به جملۀ معلوم تبدیل کرده است. همچنین ترکیب فاجعهبار «در حال داشتن» (ترجمۀ کلمهبهکلمهی was having) را به «میگذراند» یا «پشت سر میگذاشت» تغییر داده است.
مثال سوم: حذف حشو و زوائد کلام
متن خام: «در حقیقت و در واقع باید گفت که او در طول مدت زمان طولانی، تجربیات قبلی خودش را به کار بست.»
خروجی ماشین: «در واقع، او در مدتی طولانی، تجربیاتش را به کار بست.»
حذف کلمات زائد (مثل «قبلی» کنار «تجربیات»، چون تجربه همیشه مربوط به گذشته است، یا آوردن همزمان «مدت» و «زمان») کاری است که الگوریتمهای زبانی به خوبی از پس آن برمیآیند، به شرطی که به آنها دستور درستی داده شده باشد.
آن روی سکه: جاهایی که هوش مصنوعی به دیوار میخورد!
تا اینجای کار همهچیز عالی به نظر میرسد؛ اما یک متخصص ادبیات خوب میداند که زبان فقط مجموعهای از قواعد ریاضی نیست. زبان، روح دارد، موسیقی دارد و پر از استثناست. اگر کسی چشمبسته تمام متن خود را به دست ربات ویراستار فارسی بسپارد، خروجی کار متنی خواهد بود تمیز، اتوکشیده، اما بیروح، مکانیکی و گاهی کاملاً غلط!
بیایید چند مورد از گافهای رایج و محدودیتهای جدی این ابزارها را مرور کنیم:
۱. کشتن لحن و سبک شخصی نویسنده
فرض کنید متنی به سبک نثر جلال آلاحمد نوشته شده است؛ جملات کوتاه، بریدهبریده، گاهی بدون فعل، و با ساختاری عصبی و کوبنده: «رفتم. دیدم نیست. باد میآمد. سرد هم بود.»
اگر این متن به یک سیستم ویرایشگر متن هوش مصنوعی داده شود و از آن خواسته شود متن را استاندارد کند، احتمالاً چنین چیزی تحویل میدهد: «من به آنجا رفتم، اما متوجه شدم که او حضور ندارد. در همان حین، باد سردی نیز میوزید.»
فاجعه است، نه؟ ماشین فکر کرده با کامل کردن جملات و افزودن حروف ربط، به متن لطف کرده است؛ در حالی که تمام موسیقی، ضرباهنگ و امضای شخصی نویسنده را نابود کرده و یک متن انشاییِ دبیرستانی تحویل داده است. این بزرگترین خطری است که در ویراستاری کتاب با هوش مصنوعی، بهویژه در حوزۀ داستان و رمان، کمین کرده است.
۲. نفهمیدن ایهام، طنز و کنایه
در زبان فارسی، گاهی نویسنده جملهای مینویسد که ظاهرش یک چیز است و باطنش چیز دیگر.
مثال: «ماشاءالله آنقدر دستش کج است که از سایهی خودش هم میدزدد!»
در آزمایشهای متعددی که روی ابزارهای مختلف انجام شده، دیده شده که وقتی به هوش مصنوعی دستور داده میشود متن را «رسمی و علمی» ویرایش کند، کنایۀ «دست کج بودن» را به معنای نقص عضو فیزیکی میگیرد یا سعی میکند آن را به شکلی مسخره بازنویسی کند: «او به دلیل انحراف در دستانش، توانایی زیادی در پنهانکاری دارد!»
۳. توهم زبانی (Hallucination) در ویرایش محتوایی و علمی
گاهی در ویراستاری مقاله با هوش مصنوعی، سیستم برای اینکه جمله را زیباتر کند، دست به تغییر کلمات تخصصی میزند. مثلاً در یک مقالۀ حقوقی، تفاوت ظریفی بین «فسخ» و «انفساخ» وجود دارد، یا در متون ادبی و عرفانی، «حال» و «مقام» دو مفهوم کاملاً متمایزند. هوش مصنوعی ممکن است برای جلوگیری از تکرار کلمه، در جملۀ دوم به جای «فسخ» از «باطل شدن» یا «لغو» استفاده کند و کل بارِ حقوقی و علمی جمله را به هم بریزد.
۴. مشکل با متون کهن و اشعار فارسی
اگر در میان یک متن امروزی، بیتی از حافظ یا جملهای از تاریخ بیهقی تضمین شده باشد، ابزارهای خودکار اغلب گیج میشوند. ممکن است رسمالخط کهن را غلط املایی تشخیص دهند یا سعی کنند وزن شعر را با تغییر کلمات به نثر امروزی تبدیل کنند. مثلاً عبارت «بدیدم» در یک نقلقول تاریخی را به «دیدم» تغییر میدهند و اصالت امانتداری در نقلقول را از بین میبرند.
جعبه ابزار امروز: چه گزینههایی روی میز است؟
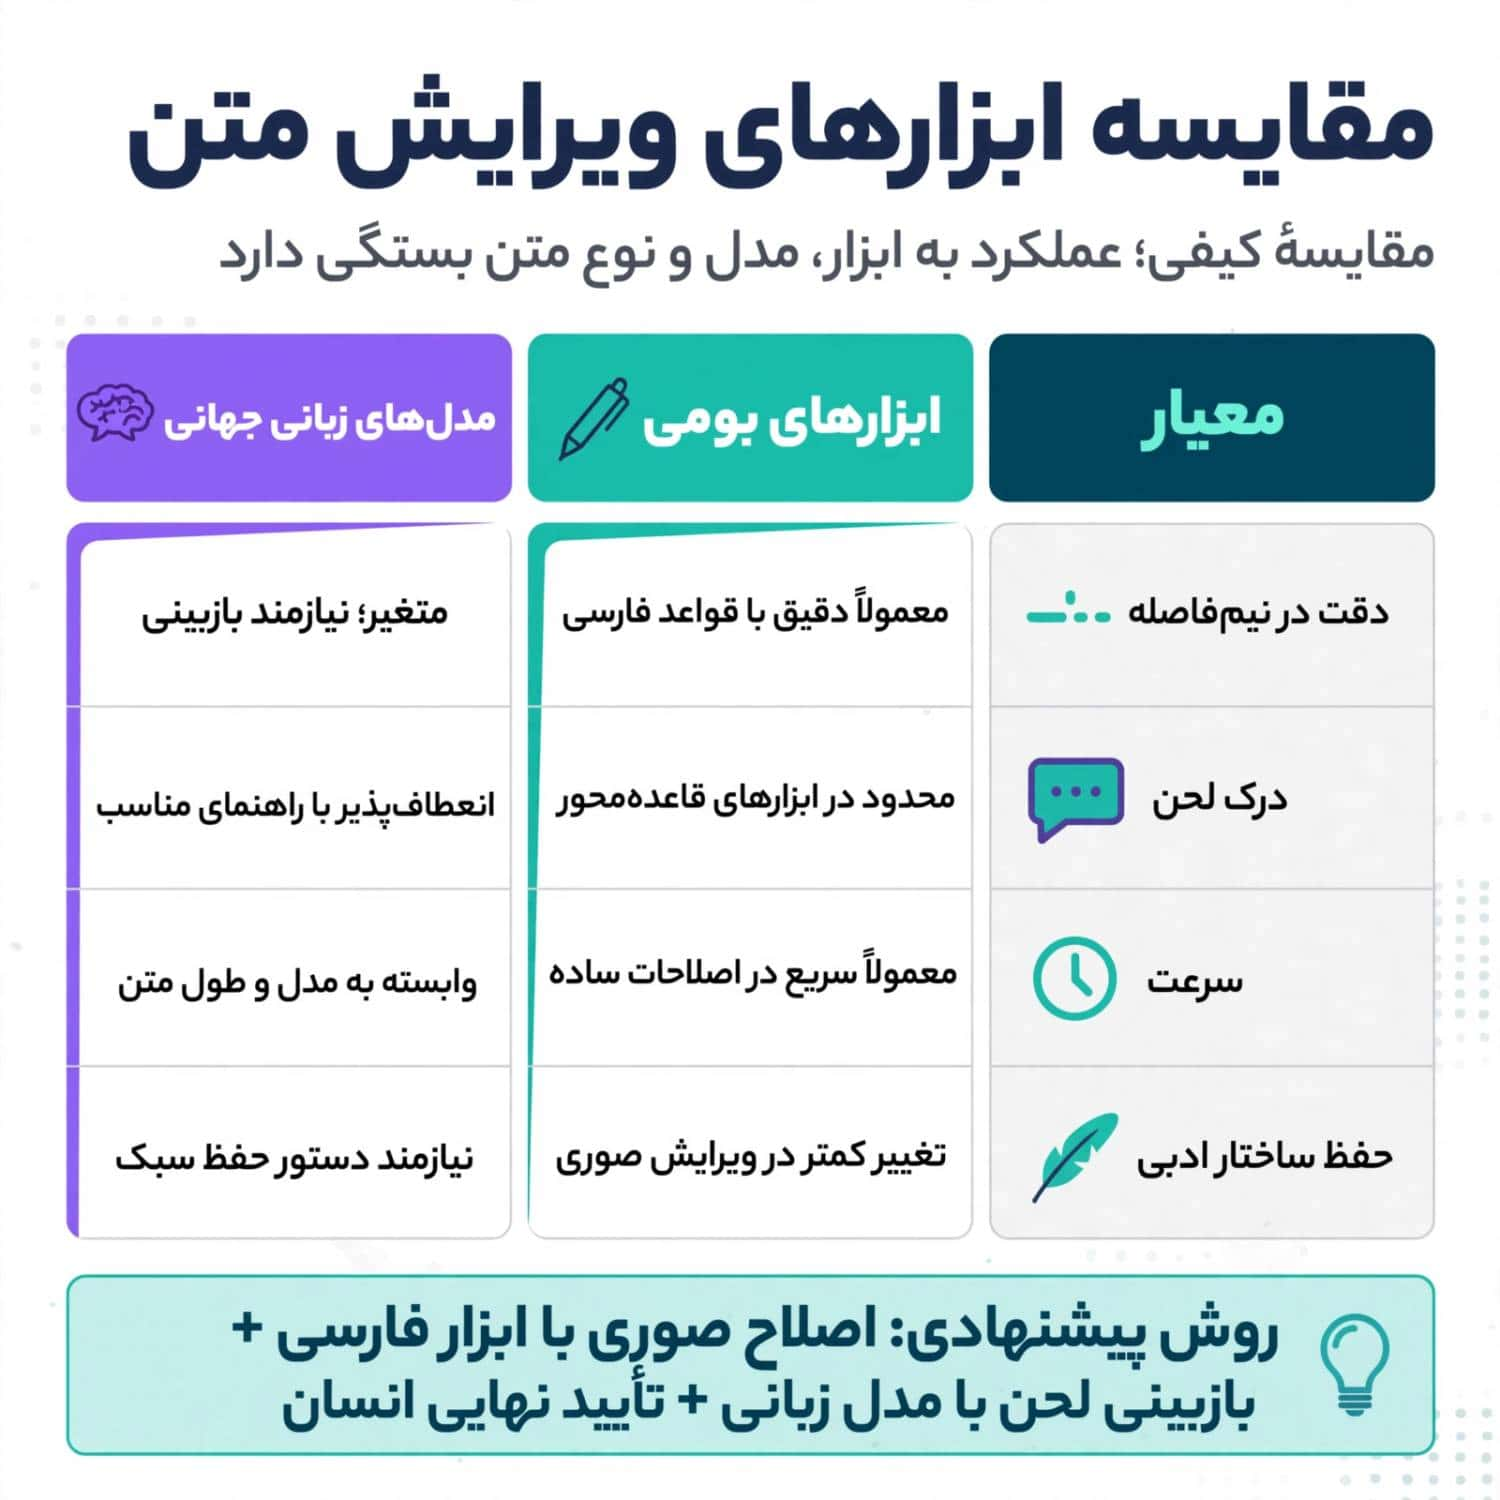
وقتی کاربران در اینترنت به دنبال سایت ویراستاری با هوش مصنوعی یا ابزارهای رایگان و پولی میگردند، با دو دستۀ کلی روبهرو میشوند. شناخت تفاوت این دو دسته برای کسی که میخواهد از این فناوری کار بکشد، حیاتی است.
دستۀ اول، ابزارهای بومی و قاعدهمند (Rule-based + AI) هستند. در ایران، نرمافزارها و پلاگینهایی مثل «پاکنویس»، «ویراستیار» (که البته بیشتر قاعدهمند است تا هوش مصنوعی مدرن، اما همچنان پای ثابت سیستمهای ویرایشی است) و پلتفرمهای آنلاین جدیدتری که بر پایۀ پردازش زبان فارسی توسعه یافتهاند، حضور دارند.
مزیت بزرگ این ابزارها این است که دقیقاً بر اساس دستور خط فرهنگستان کدنویسی شدهاند. مثلاً دقیقاً میدانند که «بیخبر» با نیمفاصله نوشته میشود، اما «بیکار» چسبیده است (چون در دستور خط، «بی» اگر بر سر اسمهای تکهجایی بیاید و معنای صفت بسازد، گاهی پیوسته نوشته میشود). این ظرافتهای استثنایی چیزی است که مدلهای خارجی گاهی در آن گیج میزنند.
دستۀ دوم، مدلهای زبانی بزرگ جهانی مثل ChatGPT (نسخههای ۴ و بالاتر)، Claude (که به شکل شگفتانگیزی در درک ظرافتهای ادبی و لحن زبان فارسی قوی عمل میکند) و Gemini هستند. این ابزارها ذاتاً یک «نرمافزار ویراستاری» به معنای کلاسیک نیستند، بلکه مغزهای متفکری هستند که اگر به آنها نقش یک ویراستار حرفهای را بدهید، معجزه میکنند.
تجربۀ ده سال کار روی متون مختلف نشان میدهد که در حال حاضر، ترکیب این دو دسته بهترین نتیجه را میدهد. یعنی برای اصلاح نیمفاصلهها و خطاهای تایپیِ انبوه، یک افزونهی بومی روی نرمافزار ورد کار را در چند دقیقه جمع میکند؛ اما برای بازنویسی جملات لَخت، پیدا کردن تناقضهای منطقی در متن و روانسازی نثر، مدلهای زبانی بزرگ مثل کلود و چتجیپیتی گزینههایی بیرقیب هستند.
فوت کوزهگری: چطور به ماشین دستور بدهیم که مثل یک ادیب ویرایش کند؟
بزرگترین اشتباهی که نویسندگان و تولیدکنندگان محتوا در هنگام ویراستاری آنلاین با هوش مصنوعی مرتکب میشوند، این است که متن را کپی میکنند، به ربات میدهند و مینویسند: «این متن را ویرایش کن!»
این دستور، بدترین دستور ممکن است. وقتی به ماشین نگویید چه نوع ویرایشی میخواهید، او به صورت پیشفرض، تهاجمیترین حالت را انتخاب میکند؛ یعنی جملات را از نو مینویسد، کلمات محبوب خودش (مثل «در نهایت»، «شایان ذکر است»، «در دنیای امروز») را در متن تزریق میکند و نوشتهی شما را به یک متن ماشینی و بیروح تبدیل میکند.
برای گرفتن یک خروجی حرفهای، باید با ماشین دقیقاً مثل یک ویراستار تازهکار اما باهوش صحبت کرد. یعنی باید «مرزها» را برایش مشخص نمود. در ادامه، چند نمونه دستور (پرامپت) کاربردی که حاصل ساعتها آزمونوخطا روی متون واقعی است، بررسی میشود:
برای ویرایش صوری بدون دست زدن به کلمات:
«تو یک ویراستار دقیق زبان فارسی هستی. این متن را فقط و فقط از نظر علائم نگارشی، نیمفاصلهها و غلطهای املایی بر اساس دستور خط فرهنگستان زبان و ادب فارسی اصلاح کن. تحت هیچ شرایطی کلمات را تغییر نده، جملات را بازنویسی نکن و لحن نویسنده را دستکاری نکن.»
برای رفع ترجمهزدگی (ویرایش زبانی):
«این متن ترجمهای از زبان انگلیسی است و ساختار جملات آن در زبان فارسی طبیعی نیست. بدون اینکه هیچ نکتهی علمی یا مفهومی از متن حذف شود، جملات مجهول را به معلوم تبدیل کن، افعال مرکب نامأنوس را با افعال روان فارسی جایگزین کن و نثر را به فارسی معیار و طبیعی امروز نزدیک کن.»
برای ویرایش مقالات علمی و دانشگاهی:
«در نقش یک ویراستار متون آکادمیک، این بخش از مقاله را بررسی کن. حشوها و تکرارهای بیمورد را حذف کن، لحن متن را کاملاً رسمی و علمی نگه دار، اما به اصطلاحات تخصصی داخل گیومه اصلاً دست نزن. در پایان، فهرستی از تغییراتی که اعمال کردی را به همراه دلیل نگارشی آن بنویس.»
نکتۀ طلایی در دستور آخر، خواستنِ «فهرست تغییرات» است. وقتی از سیستم خواسته میشود دلیل تغییراتش را توضیح دهد، درصد خطا و تغییرات سرخود به شدت پایین میآید و نویسنده میتواند با یک نگاه تشخیص دهد که کدام پیشنهاد را بپذیرد و کدام را رد کند.
ویراستاری کتاب و پایان نامه؛ میدان مین برای هوش مصنوعی!
یکی از پرسشهای پرتکرار این روزها در میان دانشجویان و نویسندگان، بحث ویراستاری پایان نامه با هوش مصنوعی یا سپردن کل یک کتاب به این سیستمهاست. اینجا جایی است که باید چراغ قرمز را روشن کرد و با احتیاط کامل جلو رفت.
اولین مشکل، محدودیت حافظه و تمرکز در مدلهای هوش مصنوعی است. شما نمیتوانید یک کتاب ۲۰۰ صفحهای را یکجا وارد سیستم کنید و بگویید «ویرایشش کن». حتی در مدلهایی که پنجرهی متنی (Context Window) بسیار بزرگی دارند و ادعا میکنند یک کتاب کامل را میخوانند، پدیدهای به نام «فراموشی در میانه» رخ میدهد. یعنی ماشین، صفحات اول و آخر را با دقت ویرایش میکند، اما در صفحات میانی، دقتش به شدت افت میکند یا بخشهایی از متن را به کلی جا میاندازد و خلاصه میکند!
دومین مشکل در کتابها و پایاننامهها، بحث «یکدستی» (Consistency) است. فرض کنید در فصل اول یک کتاب تاریخی، نام یک شخصیت خارجی «شارل» نوشته شده و در فصل هشتم، نویسنده به اشتباه او را «چارلز» خطاب کرده است. یا در یک پایاننامۀ مهندسی، یک اصطلاح در صفحۀ ۱۰ «پردازش ابری» و در صفحۀ ۸۰ «رایانش ابری» ترجمه شده است. ازآنجاییکه برای ویراستاری کتاب با هوش مصنوعی مجبورید متن را تکهتکه (پاراگراف به پاراگراف یا صفحه به صفحه) به خورد ماشین بدهید، سیستم نمیتواند این ناهماهنگیهای کلان را در طول اثر رصد کند. اینجاست که حضور یک سرویراستار انسانی برای تهیۀ «شیوهنامه» (Style Sheet) در ابتدای کار، کاملاً ضروری است.
سومین مسئله، ارجاعات، پاورقیها و منابع است. هوش مصنوعی علاقۀ عجیبی به دستکاری اعداد و فرمتهای رفرنسدهی (مثل APA یا ونکوور) دارد. بارها دیده شده که در حین ویرایش مقاله با هوش مصنوعی، سال انتشار یک منبع در داخل پرانتز به اشتباه تغییر کرده یا نام نویسندهی خارجی به فارسی ترجمه شده است! بنابراین، بخش منابع و ارجاعات درونمتنی باید همیشه خط قرمز ورود ابزارهای خودکار باشد.
فرمول طلایی «ساندویچ ویرایشی»؛ ترکیب هوش انسان و ماشین
با تمام این تفاسیر، یک تیم تحریریه یا یک نویسندۀ مستقل چطور باید از این فناوری استفاده کند تا هم در زمان و هزینه صرفهجویی شود و هم کیفیت کار مو لای درزش نرود؟ بهترین روشی که امروز در دفاتر نشر پیشرو و تیمهای تولید محتوای حرفهای اجرا میشود، روشی است که میتوان نامش را «ساندویچ ویرایشی» گذاشت:
- انسان در آغاز،
- ماشین در میانه،
- انسان در پایان.
مرحلۀ اول (لایۀ انسانی اول): تدوین شیوهنامه و نمونهخوانی
قبل از اینکه متن به هرگونه ابزار ویراستاری هوش مصنوعی سپرده شود، ویراستار انسانی دو سه صفحهی اول متن را میخواند. با این کار، بیماریهای اصلی متن را تشخیص میدهد. آیا نویسنده به استفاده از افعال مجهول اعتیاد دارد؟ آیا ویرگولها را بیجا میگذارد؟ آیا لحن متن باید خودمانی بماند یا رسمی شود؟ بر اساس این تشخیص، دستورالعمل دقیق (پرامپت) نوشته میشود.
مرحلۀ دوم (لایۀ ماشینی): پاکسازی و شخم زدن اولیه
حالا متن در بخشهای کوتاه (مثلاً هر بار ۵۰۰ تا ۸۰۰ کلمه) به همراه آن دستورالعمل دقیق، وارد سیستم هوش مصنوعی میشود. ماشین در این مرحله مثل یک بولدوزر عمل میکند: تمام غلطهای تایپی، نیمفاصلهها، جملات شکسته و ایرادهای نگارشی سطح اول را صاف میکند و پیشنهادهای بازنویسی را ارائه میدهد. این کار، حدود ۶۰ تا ۷۰ درصد از زمانِ خستهکنندهی ویرایش را میبلعد و جلو میاندازد.
مرحلۀ سوم (لایۀ انسانی نهایی): بازبینی، روحبخشی و کنترل کیفیت
در این مرحله، متنِ خروجی ماشین روی میز ویراستار انسانی قرار میگیرد؛ ترجیحاً در حالت مقایسه (Track Changes در ورد) تا دقیقاً مشخص باشد ماشین چه بلایی سر متن آورده است. ویراستار با چشم مسلح و ذوق ادبی خود، متن را میخواند. هر جا ماشین زیادی مته به خشخاش گذاشته و زیباییِ جمله را گرفته، به حالت اول برمیگرداند؛ استعارهها و کنایهها را نجات میدهد؛ دقت علمی کلمات را چک میکند و مطمئن میشود که متن، بوی پلاستیک و ربات نمیدهد.
آیا شغل ویراستاری در خطر انقراض است؟
این سؤالی است که در تمام محافل ادبی و صنفی پرسیده میشود. پاسخ کوتاه و صریح این است:
«ویراستارانِ تایپیست» بله، منقرض میشوند؛ اما «ویراستارانِ ادیب» نه تنها بیکار نمیشوند، بلکه ارزش کارشان چند برابر خواهد شد.
تا پیش از این، بخش بزرگی از بازار کار ویراستاری در اختیار کسانی بود که کارشان صرفاً گذاشتن نیمفاصله، تبدیل «می شود» به «میشود» و گرفتن غلطهای املایی تابلو بود. طبیعی است که با آمدن ویراستاری با هوش مصنوعی رایگان و در دسترس بودن آن برای همه، دیگر هیچ نویسنده یا کارفرمایی حاضر نیست برای چنین کار سطحی و مکانیکیای هزینه و زمان صرف کند.
اما در عوض، حجم تولید محتوا و کتابهای متنی (که اتفاقاً بسیاری از آنها با کمک خود هوش مصنوعی نوشته یا ترجمه شدهاند!) به شدت بالا رفته است. این متونِ انبوه، به شدت نیازمند ویرایشهای عمیق، بومیسازی، لحنبخشی و راستیآزمایی هستند. هوش مصنوعی متنی تولید میکند که از نظر قواعد دستوری کاملاً سالم است، اما روح ندارد، تکراری است و مخاطب را خسته میکند. چه کسی میتواند به این کالبد بیجان روح بدمد؟ فقط و فقط کسی که ادبیات میداند، موسیقی کلمات را میشناسد، با فرهنگ و زبان کوچه و بازار آشناست و روانشناسی مخاطب را درک میکند.
در واقع، نقش ویراستار در حال تغییر از یک «تعمیرکارِ کلمات» به یک «کارگردانِ متن» است. کارگردانی که ابزارهای هوش مصنوعی را به عنوان دستیاران صحنه و تدارکات به کار میگیرد تا کارهای سیاهیلشکر را انجام دهند و خودش تمام تمرکزش را روی بازیِ کلمات و خلق معنا بگذارد.
حریم خصوصی و امنیت متون؛ نکتهای که کمتر کسی به آن توجه میکند
یک نکتهی بسیار مهم که در بررسی تجربیات کاربران و دغدغههای ناشران حرفهای به چشم میخورد، بحث محرمانگی و کپیرایت است. وقتی یک نویسنده، رمان منتشرنشدهی خود را یا یک پژوهشگر، مقالهی علمیِ ثبتنشدهاش را در یک سایت ویراستاری با هوش مصنوعی بارگذاری میکند، باید بداند که در نسخههای رایگانِ بیشتر این پلتفرمها، از متون ورودی کاربران برای آموزش دادنِ مدلهای بعدی استفاده میشود.
به زبان ساده، متن شما وارد حافظۀ جمعی آن سیستم میشود. برای متون عمومی، وبلاگها و نوشتههای روزمره، این موضوع هیچ اهمیتی ندارد. اما برای اسناد تجاری محرمانه، کتابهایی که قرار است برای اولین بار چاپ شوند و حق تألیف سنگینی دارند، یا پایاننامههایی که حاوی ایدههای ثبتنشده هستند، استفاده از ابزارهای آنلاین رایگان ریسک بزرگی است. در این موارد، متخصصان یا از نسخههای سازمانی (Enterprise) استفاده میکنند که تضمین میدهند دادهها ذخیره نمیشوند، یا سراغ نرمافزارهای آفلاین و مدلهای هوش مصنوعی محلی (Local LLMs) میروند که روی کامپیوتر شخصی نصب میشوند و هیچ ارتباطی با اینترنت ندارند.
جمعبندی یک دهه تجربه در یک نگاه
زبان فارسی، دریایی است پر از گوهرهای پیدا و پنهان که در طول بیش از هزار سال، از رودکی و فردوسی تا سعدی و هدایت و شاملو، صیقل خورده و به ما رسیده است. هیچ الگوریتم ریاضی و هیچ ابرکامپیوتری، هرچقدر هم که پیچیده باشد، نمیتواند ذوقِ نشستنِ یک کلمهی ناب در جای درستش را درک کند؛ همانطور که نمیتواند از شنیدن یک ایهام ظریف در غزل حافظ لبخند بزند.
با این همه، نادیده گرفتن قدرت ویراستاری با هوش مصنوعی در دنیای پرشتاب امروز، مثل این است که یک خطاط ماهر اصرار داشته باشد برای نوشتن یک نامهی اداری ساده، هنوز هم باید دوات و قلمنی بتراشد! فناوری آمده است تا بارِ حمالیِ متن را از دوش انسان بردارد. گذاشتن نقطهها، تنظیم نیمفاصلهها، پیدا کردن فعلهای جاافتاده و صاف کردن پیچوخمهای ناشیانهی جملات، کارهایی است که ماشین با سرعتی خیرهکننده و دقتی بالا انجام میدهد.
هنر یک نویسنده، مترجم یا ویراستار امروزی در این است که این دستیار پرسرعت اما بیذوق را رام کند؛ افسارش را در دست بگیرد، کارهای تکراری را به او بسپارد و در نهایت، خودش با همان قلم قرمزِ جادویی، مهرِ اصالت و زیباییِ انسانی را پای متن بزند. متنِ خوب، متنی نیست که فقط غلط نداشته باشد؛ متنِ خوب متنی است که وقتی خواننده آن را میخواند، صدای نفس کشیدنِ یک انسانِ دیگر را در پشت کلمات بشنود؛ و این، کاری است که تا ابد در انحصار انسان باقی خواهد ماند.